

¿Le preocupa constantemente que un fallo del DCS paralice todas sus operaciones? Las pérdidas económicas son enormes. Los riesgos para la seguridad son aún mayores. Necesita un sistema totalmente fiable.
Los problemas más frecuentes de los sistemas de control distribuido (DCS) en el sector del petróleo y el gas se derivan de fallos de hardware, errores de software, errores de comunicación de red y errores humanos. Puede reducir estos riesgos con un mantenimiento proactivo, fuertes medidas de ciberseguridad y formación continua para sus operadores. Esto garantiza la seguridad y la eficiencia de la planta.

Usted sabe que un pequeño fallo en el sistema de control puede convertirse rápidamente en un incidente grave. La presión para mantener el tiempo de funcionamiento y la seguridad es inmensa. Como ingeniero jefe, usted es responsable de toda la estrategia técnica, desde el diseño hasta las operaciones diarias. Un conocimiento profundo de los posibles puntos de fallo del DCS no sólo es útil, sino que es esencial para su función. Tenemos que examinar de cerca estos retos para construir un sistema verdaderamente resistente. Vamos a desglosar los problemas más comunes a los que se enfrentará, empezando por los componentes físicos de su sistema.
Prevención de fallos críticos del hardware DCS
El fallo de una sola tarjeta controladora puede parar toda una unidad. Se enfrenta a un tiempo de inactividad inmediato y a una gran presión para que la planta vuelva a funcionar. Cada minuto de retraso cuesta dinero. Un enfoque proactivo es su mejor defensa contra estas emergencias de hardware.
Puede evitar la mayoría de los fallos del hardware DCS con un estricto programa de mantenimiento preventivo. Inspeccione y limpie periódicamente los componentes clave, como controladores, módulos de E/S y fuentes de alimentación. Debe mantener un inventario detallado de las piezas de repuesto críticas y gestionar el entorno de las salas de control para prolongar la vida útil del hardware.
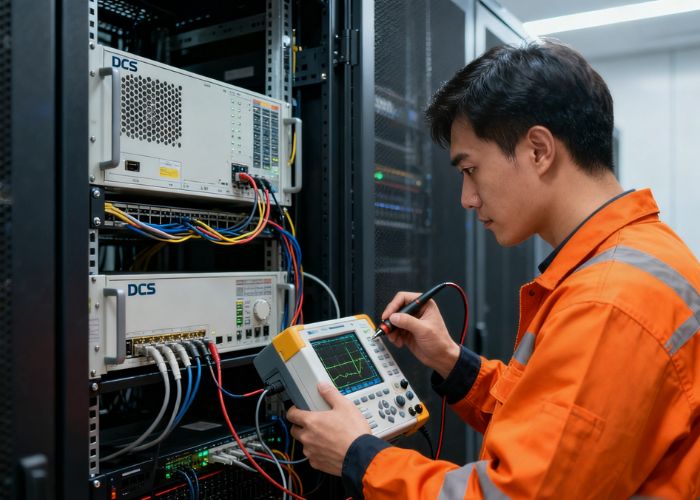
Como ingeniero jefe, la salud física de su DCS es su base. He visto proyectos retrasados durante semanas por una sola pieza obsoleta difícil de encontrar. Su función consiste en planificar a largo plazo, lo que significa enfrentarse a la realidad del envejecimiento del hardware.
El reto del envejecimiento de las infraestructuras
Muchas refinerías y plantas químicas funcionan con equipos DCS de más de 15 o 20 años de antigüedad. Estos equipos han prestado un buen servicio, pero presentan un riesgo creciente. Los fabricantes dejan de producir módulos antiguos, lo que hace que encontrar piezas de repuesto sea muy difícil y caro. Es posible que tenga que recurrir a revendedores externos, y la calidad de estas piezas no siempre está garantizada. Un fallo en un componente obsoleto puede provocar paradas prolongadas mientras su equipo lucha por encontrar un repuesto. Como responsable técnico, debe defender firmemente la migración por fases y las actualizaciones del sistema. Debe presentar datos claros a la dirección sobre los riesgos financieros y operativos de confiar en tecnología obsoleta. Se trata de garantizar la capacidad de producción futura de la planta.
Los factores ambientales son asesinos silenciosos
Los entornos de las instalaciones de petróleo y gas son duros. Las salas de control y los armarios de campo suelen estar expuestos al calor, la humedad y los elementos corrosivos. Estas condiciones aceleran la degradación de los componentes electrónicos. Recuerdo a un cliente de una terminal costera de gas natural licuado que sufría constantes fallos en las tarjetas de E/S. La causa era la sal en el aire, que provocaba la corrosión de los componentes electrónicos. La causa era la sal del aire, que provocaba microcorrosión en las tarjetas de circuitos. Problemas tan simples como el fallo de los ventiladores de refrigeración o la obstrucción de los filtros de aire pueden sobrecalentar los componentes y provocar fallos intermitentes muy difíciles de diagnosticar. Debe asegurarse de que los sistemas de control ambiental de sus salas de equipos DCS formen parte de su plan de mantenimiento crítico. Se trata de un paso sencillo que evita muchos problemas complejos.
Una estrategia de mantenimiento proactiva
Un enfoque reactivo del hardware es una receta para el desastre. Debe abogar por una estrategia proactiva. Esto implica algo más que comprobaciones de calendario. Requiere un plan integral que incluya diagnósticos periódicos, imágenes térmicas de los armarios para detectar componentes sobrecalentados y un inventario de piezas de repuesto bien gestionado. Su equipo debe saber exactamente dónde se encuentra cada repuesto crítico y cómo instalarlo rápidamente. Contar con un plan claro reduce el pánico y minimiza el tiempo de inactividad en caso de avería.
He aquí una tabla sencilla para estructurar su lista de comprobación de mantenimiento del hardware:
| Componente | Control semanal | Cheque mensual | Control anual |
|---|---|---|---|
| Controladores | Compruebe los LED de estado | Ejecutar el diagnóstico del sistema | Copia de seguridad completa y revisión del firmware |
| Fuentes de alimentación | Verificar tensiones de salida | Limpiar ventiladores y rejillas de ventilación | Prueba de redundancia y conmutación por error |
| Módulos de E/S | Comprobación de los indicadores de avería | Inspección visual de corrosión/daños | Calibrar entradas/salidas analógicas |
| Conmutadores de red | Compruebe los LED de estado del puerto | Revisar registros de errores | Actualización del firmware y copia de seguridad de la configuración |
| Servidores/Estaciones de trabajo | Monitorizar el uso de CPU/Memoria | Filtros de polvo limpios | Aplicar parches de seguridad y actualizaciones del sistema |
Al implantar y aplicar este enfoque estructurado, el mantenimiento deja de ser un centro de costes y se convierte en una herramienta estratégica para garantizar la fiabilidad y seguridad de la planta, que es su principal responsabilidad.
Gestión de software DCS complejo y riesgos de ciberseguridad
Un error de software puede ser tan perjudicial como un fallo de hardware. Los reinicios inesperados del sistema o la ejecución incorrecta de la lógica pueden causar trastornos en los procesos. La creciente amenaza de ciberataques añade otra capa de riesgo que debe gestionar con cuidado.
Para gestionar estos riesgos, es necesario un estricto protocolo de gestión del software. Esto incluye la aplicación periódica de parches, la realización de copias de seguridad completas del sistema y el acceso controlado a la estación de ingeniería. También debe implantar una estrategia de ciberseguridad de defensa en profundidad con cortafuegos, segmentación de la red y supervisión continua para proteger su infraestructura crítica.
En su puesto, usted es la autoridad final en soluciones técnicas, y esto incluye ahora la integridad digital de la planta. Un fallo de software no es sólo un problema informático; es un problema de seguridad del proceso. Los límites entre el control de procesos y la ciberseguridad han desaparecido, y usted debe liderar los esfuerzos para proteger sus operaciones de estas amenazas invisibles.
Los peligros ocultos de los fallos de software
El software DCS es increíblemente complejo. Incluso con pruebas rigurosas por parte del proveedor, pueden existir fallos. Estos pueden permanecer latentes durante años hasta que un conjunto específico de condiciones los desencadena. Trabajé con una planta química en la que una actualización menor del software provocó una fuga de memoria. Durante varios días, el sistema se ralentizó hasta que un controlador crítico se bloqueó, forzando el cierre de la unidad. La causa raíz fue difícil de encontrar porque no se trataba de un fallo directo del mando. Su responsabilidad es garantizar que cualquier cambio de software, desde un parche menor hasta una actualización importante, se pruebe exhaustivamente en un entorno de desarrollo o simulación antes de implantarlo en el sistema activo. Debe tener un plan de reversión claro en caso de que algo vaya mal. Apresurar una actualización de software para ganar tiempo puede costarle mucho más a largo plazo.
Ciberseguridad: La nueva frontera de la seguridad de las instalaciones
Historically, DCS networks were isolated from business networks, creating an "air gap" for protection. This is no longer the case. The need for real-time production data and remote monitoring has connected these systems, creating new vulnerabilities. A cyberattack on your DCS is a direct threat to physical safety and environmental compliance. A malicious actor could manipulate valve positions, disable safety alarms, or shut down entire processes, leading to catastrophic consequences. As the chief engineer, you must work closely with IT and cybersecurity specialists to implement a robust security framework. This is not just about installing a firewall. It involves a multi-layered approach.
He aquí cómo puede estructurar su defensa:
- Segmentación de la red: Debe aislar la red de control de procesos de la red corporativa. Utilice cortafuegos y zonas desmilitarizadas (DMZ) para controlar estrictamente el tráfico que pasa entre ellas. Esto evita que un compromiso en el lado empresarial afecte directamente a las operaciones de la planta.
- Control de acceso: Hay que aplicar el principio del menor privilegio. Los ingenieros, operadores y personal de mantenimiento sólo deben tener acceso a los sistemas y funciones que necesiten absolutamente para hacer su trabajo. Utilice contraseñas seguras, autenticación de dos factores y mantenga un registro claro de todos los accesos al sistema.
- Endurecimiento del sistema: Debe desactivar todos los puertos, servicios y software innecesarios en los componentes DCS. Cada puerta abierta es un punto de entrada potencial para un ataque. También debe tener una política estricta para el uso de medios extraíbles como unidades USB, ya que son un vector común para la infección de malware.
Su liderazgo es fundamental para crear una cultura de concienciación sobre la seguridad. Todas las personas que interactúan con el DCS, desde el operador de la sala de control hasta los proveedores externos, deben comprender su papel en la protección del sistema.
Garantizar la solidez de la red DCS y la integridad de las comunicaciones
Su DCS es un distribuido sistema. Su fiabilidad depende totalmente de la red de comunicaciones que lo une todo. Un fallo de la red puede aislar los controladores y dejar a sus operadores a ciegas, creando instantáneamente una situación peligrosa.
Para garantizar la integridad de la red, debe diseñar la redundancia. Utilice anillos de fibra óptica redundantes, conmutadores de red redundantes y diversas rutas de cable. Supervise regularmente el tráfico y el estado de la red. También debe realizar pruebas periódicas de los sistemas de conmutación por error para asegurarse de que funcionan como se espera.
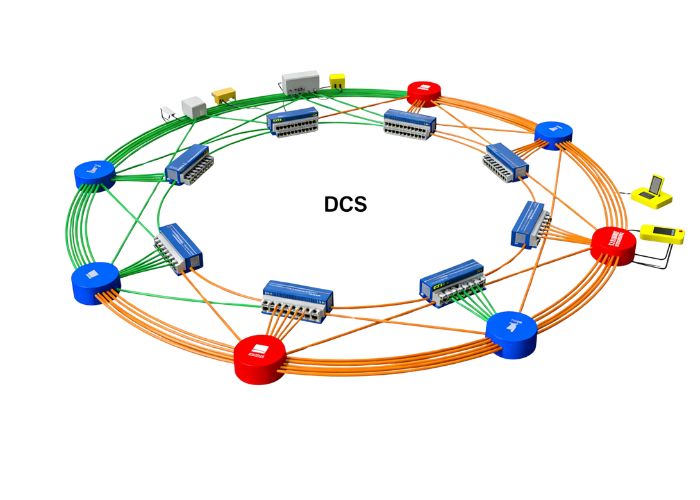
Cuando se diseña una nueva planta o una ampliación, la arquitectura de red es una de las decisiones más críticas que hay que tomar. Es el sistema nervioso central de toda la operación. Mi padre siempre me decía que una válvula es tan buena como la tubería a la que está conectada. Del mismo modo, un controlador es tan bueno como la red a la que está conectado. Un fallo aquí puede tener un impacto más amplio que un único fallo de hardware.
El papel fundamental de la redundancia
En la industria del petróleo y el gas, no hay lugar para puntos únicos de fallo. Este principio es especialmente válido para su red DCS. Un diseño de red estándar puede ser aceptable para una oficina, pero no es suficiente para el control de procesos. Debe insistir en topologías de red totalmente redundantes. Una topología en anillo con cables de fibra óptica redundantes es una solución común y eficaz. Si se corta un cable o falla un conmutador, los datos se redirigen automáticamente en la otra dirección con una interrupción mínima. Esta conmutación por error debe ser fluida y automática. Sin embargo, no se puede dar por sentado que funciona. Como parte de sus planes de puesta en marcha y mantenimiento periódico, debe programar pruebas para simular un fallo. Desconecte un cable o apague un interruptor para comprobar que el sistema responde correctamente. Descubrir que su redundancia no funciona durante una emergencia real es demasiado tarde.
Diagnóstico de fallos de comunicación intermitentes
Some of the most frustrating problems to solve are intermittent communication errors. An operator might report that a value on their screen froze for a few seconds or that a command was slow to respond. These "ghosts in the machine" can be caused by many things: a failing network card, a loose connection, or electromagnetic interference (EMI) from nearby equipment like large motors or variable frequency drives (VFDs). The first step is to check the network diagnostics and error logs on your switches and controllers. These often provide clues about where the problem is located. You should also ensure that all network cabling, especially in the field, is properly shielded and grounded according to industry standards. In my experience helping clients specify control valves, I have seen issues where the electrical noise from a VFD’s power cable interfered with the 4-20mA signal from a valve positioner because the cables were run in the same conduit. The same principle applies to your network cables. Proper installation is key.
Gestión de la carga y el rendimiento de la red
A medida que añades más dispositivos y datos a tu sistema, puedes empezar a experimentar problemas de rendimiento de la red. Si la red se sobrecarga, los paquetes de datos pueden retrasarse o perderse. Esto puede afectar al rendimiento de los bucles de control y a la capacidad de respuesta de la interfaz del operador. Como ingeniero jefe que supervisa el diseño, debe planificar la capacidad futura. Elija conmutadores con ancho de banda suficiente para gestionar no sólo la carga actual, sino también la prevista tras futuras ampliaciones. Puede utilizar herramientas de supervisión de red para hacer un seguimiento de la utilización del ancho de banda e identificar cuellos de botella. Esto le permite abordar posibles problemas de rendimiento antes de que afecten a las operaciones de la planta. Se trata de diseñar un sistema que no sólo sea fiable hoy, sino también escalable para el futuro.
Conclusión
Dominar su DCS requiere una estrategia completa de hardware, software y redes. Un mantenimiento proactivo y una seguridad sólida son las claves para un funcionamiento seguro y rentable.


 English
 Arabic
 Russian
 French
 Spanish